行业22 分钟评分 78
没有 Jensen 的开源 AI:英伟达 CEO 离任对开源模型生态的影响
文章讨论英伟达 CEO Jensen Huang 离任对开源模型生态的冲击:他此前以创始人式的大笔投入支持开源模型,这种支持很可能随其离任而收缩。作者认为开源模型真正的商品化远未实现,算力紧缺使推理利润居高不下,闭源实验室反而更具优势;美国需要孵化出真正的前沿开源模型玩家,而关键瓶颈是人才而非资金。
Interconnects · 模型与研究进展解读
资料库收录的全部内容,新的在前。
文章讨论英伟达 CEO Jensen Huang 离任对开源模型生态的冲击:他此前以创始人式的大笔投入支持开源模型,这种支持很可能随其离任而收缩。作者认为开源模型真正的商品化远未实现,算力紧缺使推理利润居高不下,闭源实验室反而更具优势;美国需要孵化出真正的前沿开源模型玩家,而关键瓶颈是人才而非资金。
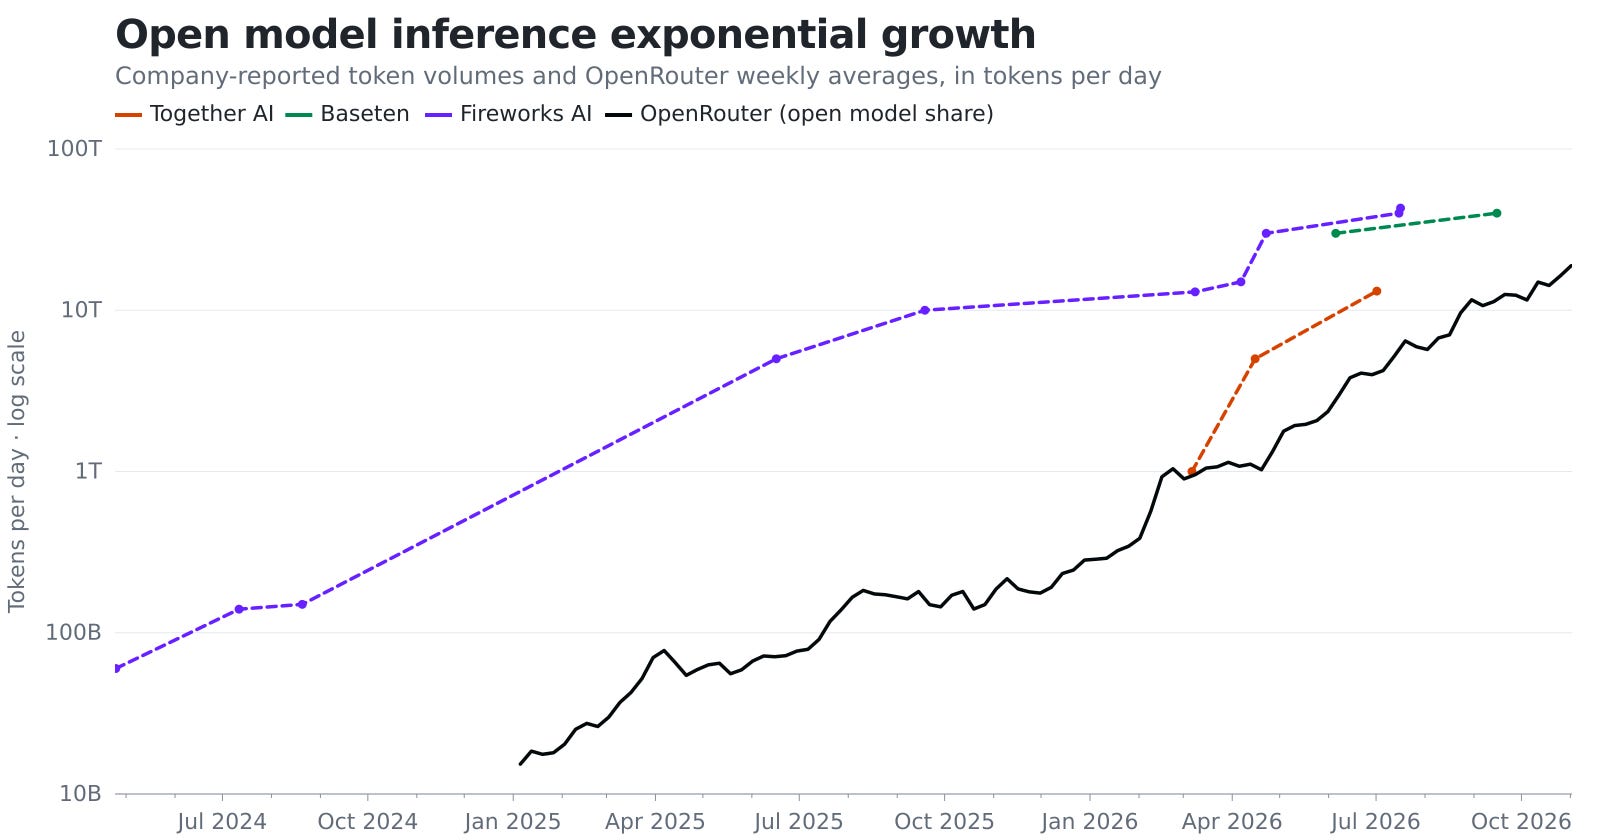
作者用自己搭建的 Interconnects Dashboard 汇总开放模型采用与性能数据,并以 Baseten、Fireworks、Together AI 以及 OpenRouter 上开放模型的 token 占比作为判断开放模型推理市场的参照,估算开放模型推理市场的规模,再与 Google 等闭源或超大规模平台的 token 量对比。公开数据显示,开放模型推理量接近指数增长:Fireworks 称其定制模型每天服务超过 40T tokens,该业务较今年夏天增长 2 倍以上。作者同时强调,现有关于开放模型采用度的测量都极不精确,需要交叉验证。
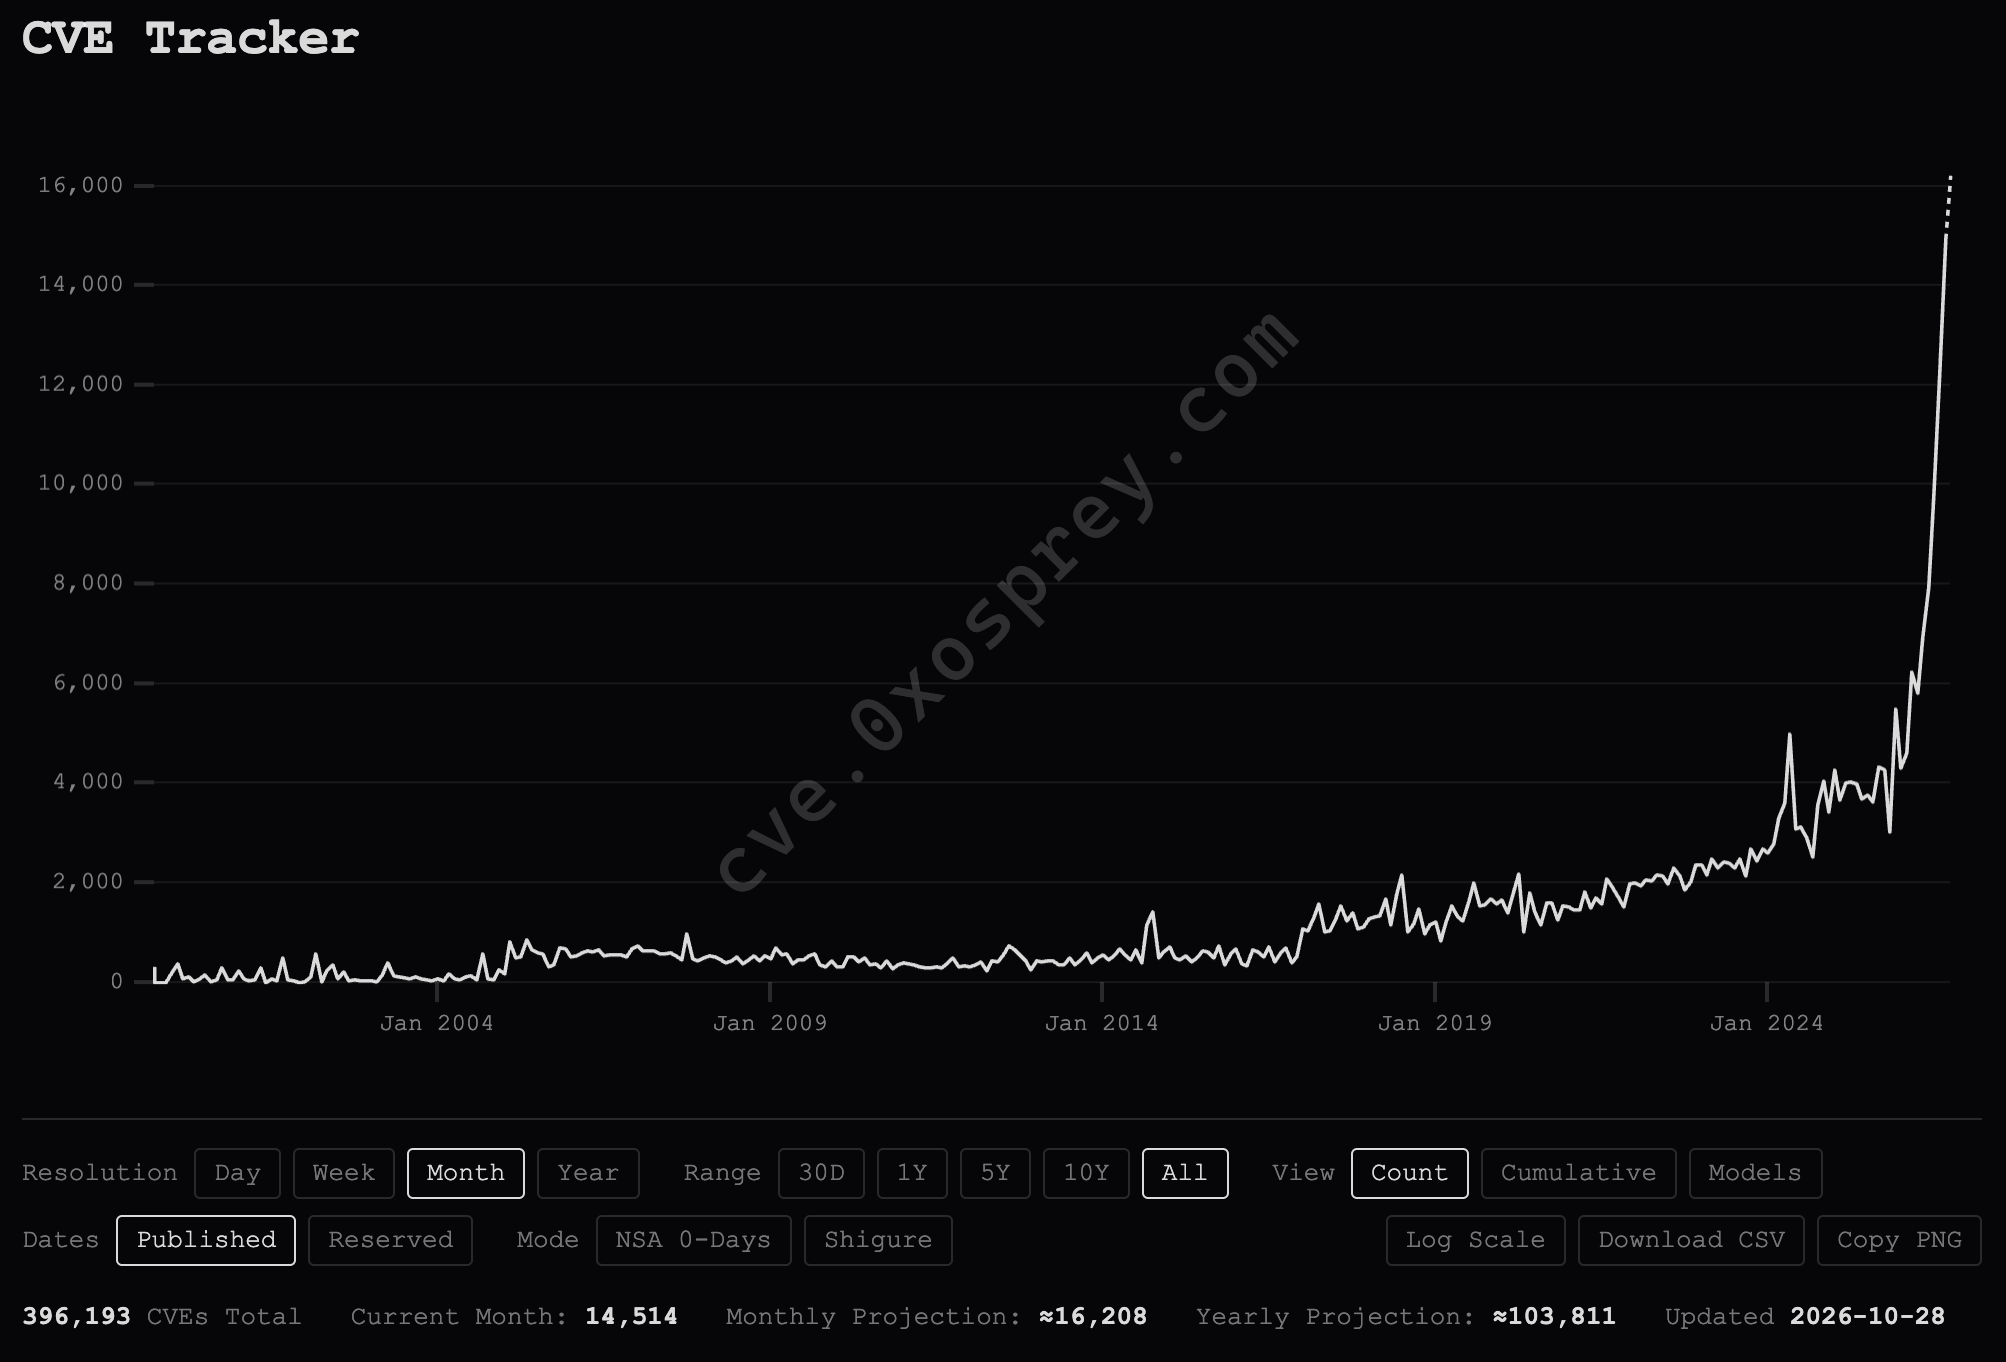
作者回顾自己此前“开放权重模型不会造成灾难性网络安全风险”的判断,并回应外界批评。他以 GLM-5.3 开放权重一个多月后公开证据未见剧变、Epoch AI 用该模型发现 Firefox 漏洞链为例,指出漏洞发现只是多阶段攻击中的一环;攻击者的行为更像有既定业务流程的公司,因此风险更像是加速而非阶跃式突变。
文章以 Artificial Analysis 发布 Intelligence Index v5 为切入点,讨论独立模型评测的困境:要把能力压缩成单一数字便于比较,但任何聚合方式都有取舍,而评测方如今掌握着万亿市场的胜负权重。作者分析了 v5 的权重构成与排名,认为其偏向衡量前沿模型走向,拉大了开源与闭源模型的差距,并讨论了私有基准带来的透明度问题。
Interconnects 的 Nathan 和 Florian 讨论 Kimi K3.1 Pro 为何在 Artificial Analysis 上分数极高却反响不一:短时程基准与 ProgramBench 这类探索型长任务表现分化,可能反映 RL 训练偏利用而非探索。节目还讨论开放权重模型的网络安全风险、专家认知差异,以及模型发布日益专业化的现象。
Interconnects 的开放模型产物汇总第 25 期,先梳理了中美对开放权重模型的最新监管动作:中国商务部提出政策提案,要求前沿 AI 模型等技术的国际共享需预先审批(开源技术拟走自动批准通道),美国国土安全部则下令限制 DeepSeek 作为联邦民用采购供应商。作者认为更值得关注的是 DeepSeek 公开了内部推理栈 DeepInfer,估计其 token 销售毛利率可达 90%。其余篇幅盘点了小米 MiMo-V2.6-Pro-RL、DeepSeek-V4.1-Flash-1017(552B-A16B、支持图像输入、MIT 许可)、Cloudflare Clef、NVIDIA Nemotron-3.5-Super-VL、Reflection Beam-1.0 等新模型。
Interconnects 分析 Meta 近期同时发布开源权重模型 Muse Spark Open 与闭源前沿模型 Muse Wonder 系列,认为这让 Meta 成为唯一同时拥有前沿开源与闭源模型的美国公司,把美国开源模型与中国的差距大致缩小了一半。文章拆解了 Muse Spark Open 的规格与性能定位(高于 GLM 5.2、接近 DeepSeek V4.1 Flash、落后 GLM 5.3 与 Kimi K3),并重点批评其自定义许可证的诸多限制,认为复杂非标准许可证是开源实验室争取采用率时不必要的战略风险。
作者认为,业界顶尖研究者之所以预期 AI 很快会超越自己,是因为他们看到模型在基础设施和工程能力上的加速,而非模型本质的跃变。未来几年,AI Agent 会端到端优化训练与推理栈,使模型智能的有效成本接近指数下降,预训练架构与数据选择的研究也可能在 2–3 年内自动化;但这带来的是技术扩散和 Jevons 悖论式的需求增长,而不是通用超级智能。
作者认为当前关于开放权重模型网络风险的讨论被两极叙事主导:一方主张封禁开放模型,另一方强调开放模型对防御的必要性,而双方都缺少对权衡与跨阵营问题的实质讨论。文章批评 Anthropic 关于 GLM-5.3 网络攻击能力的报告只做技术评估,却不回答封禁开放模型会带来什么后果、中国公司为何认为可以发布。作者还梳理了中国 AI 风险治理的内生逻辑,并指出若因网络风险封禁开放模型,就应同样限制前沿闭源模型的公开 API。