研究解读138 分钟评分 88
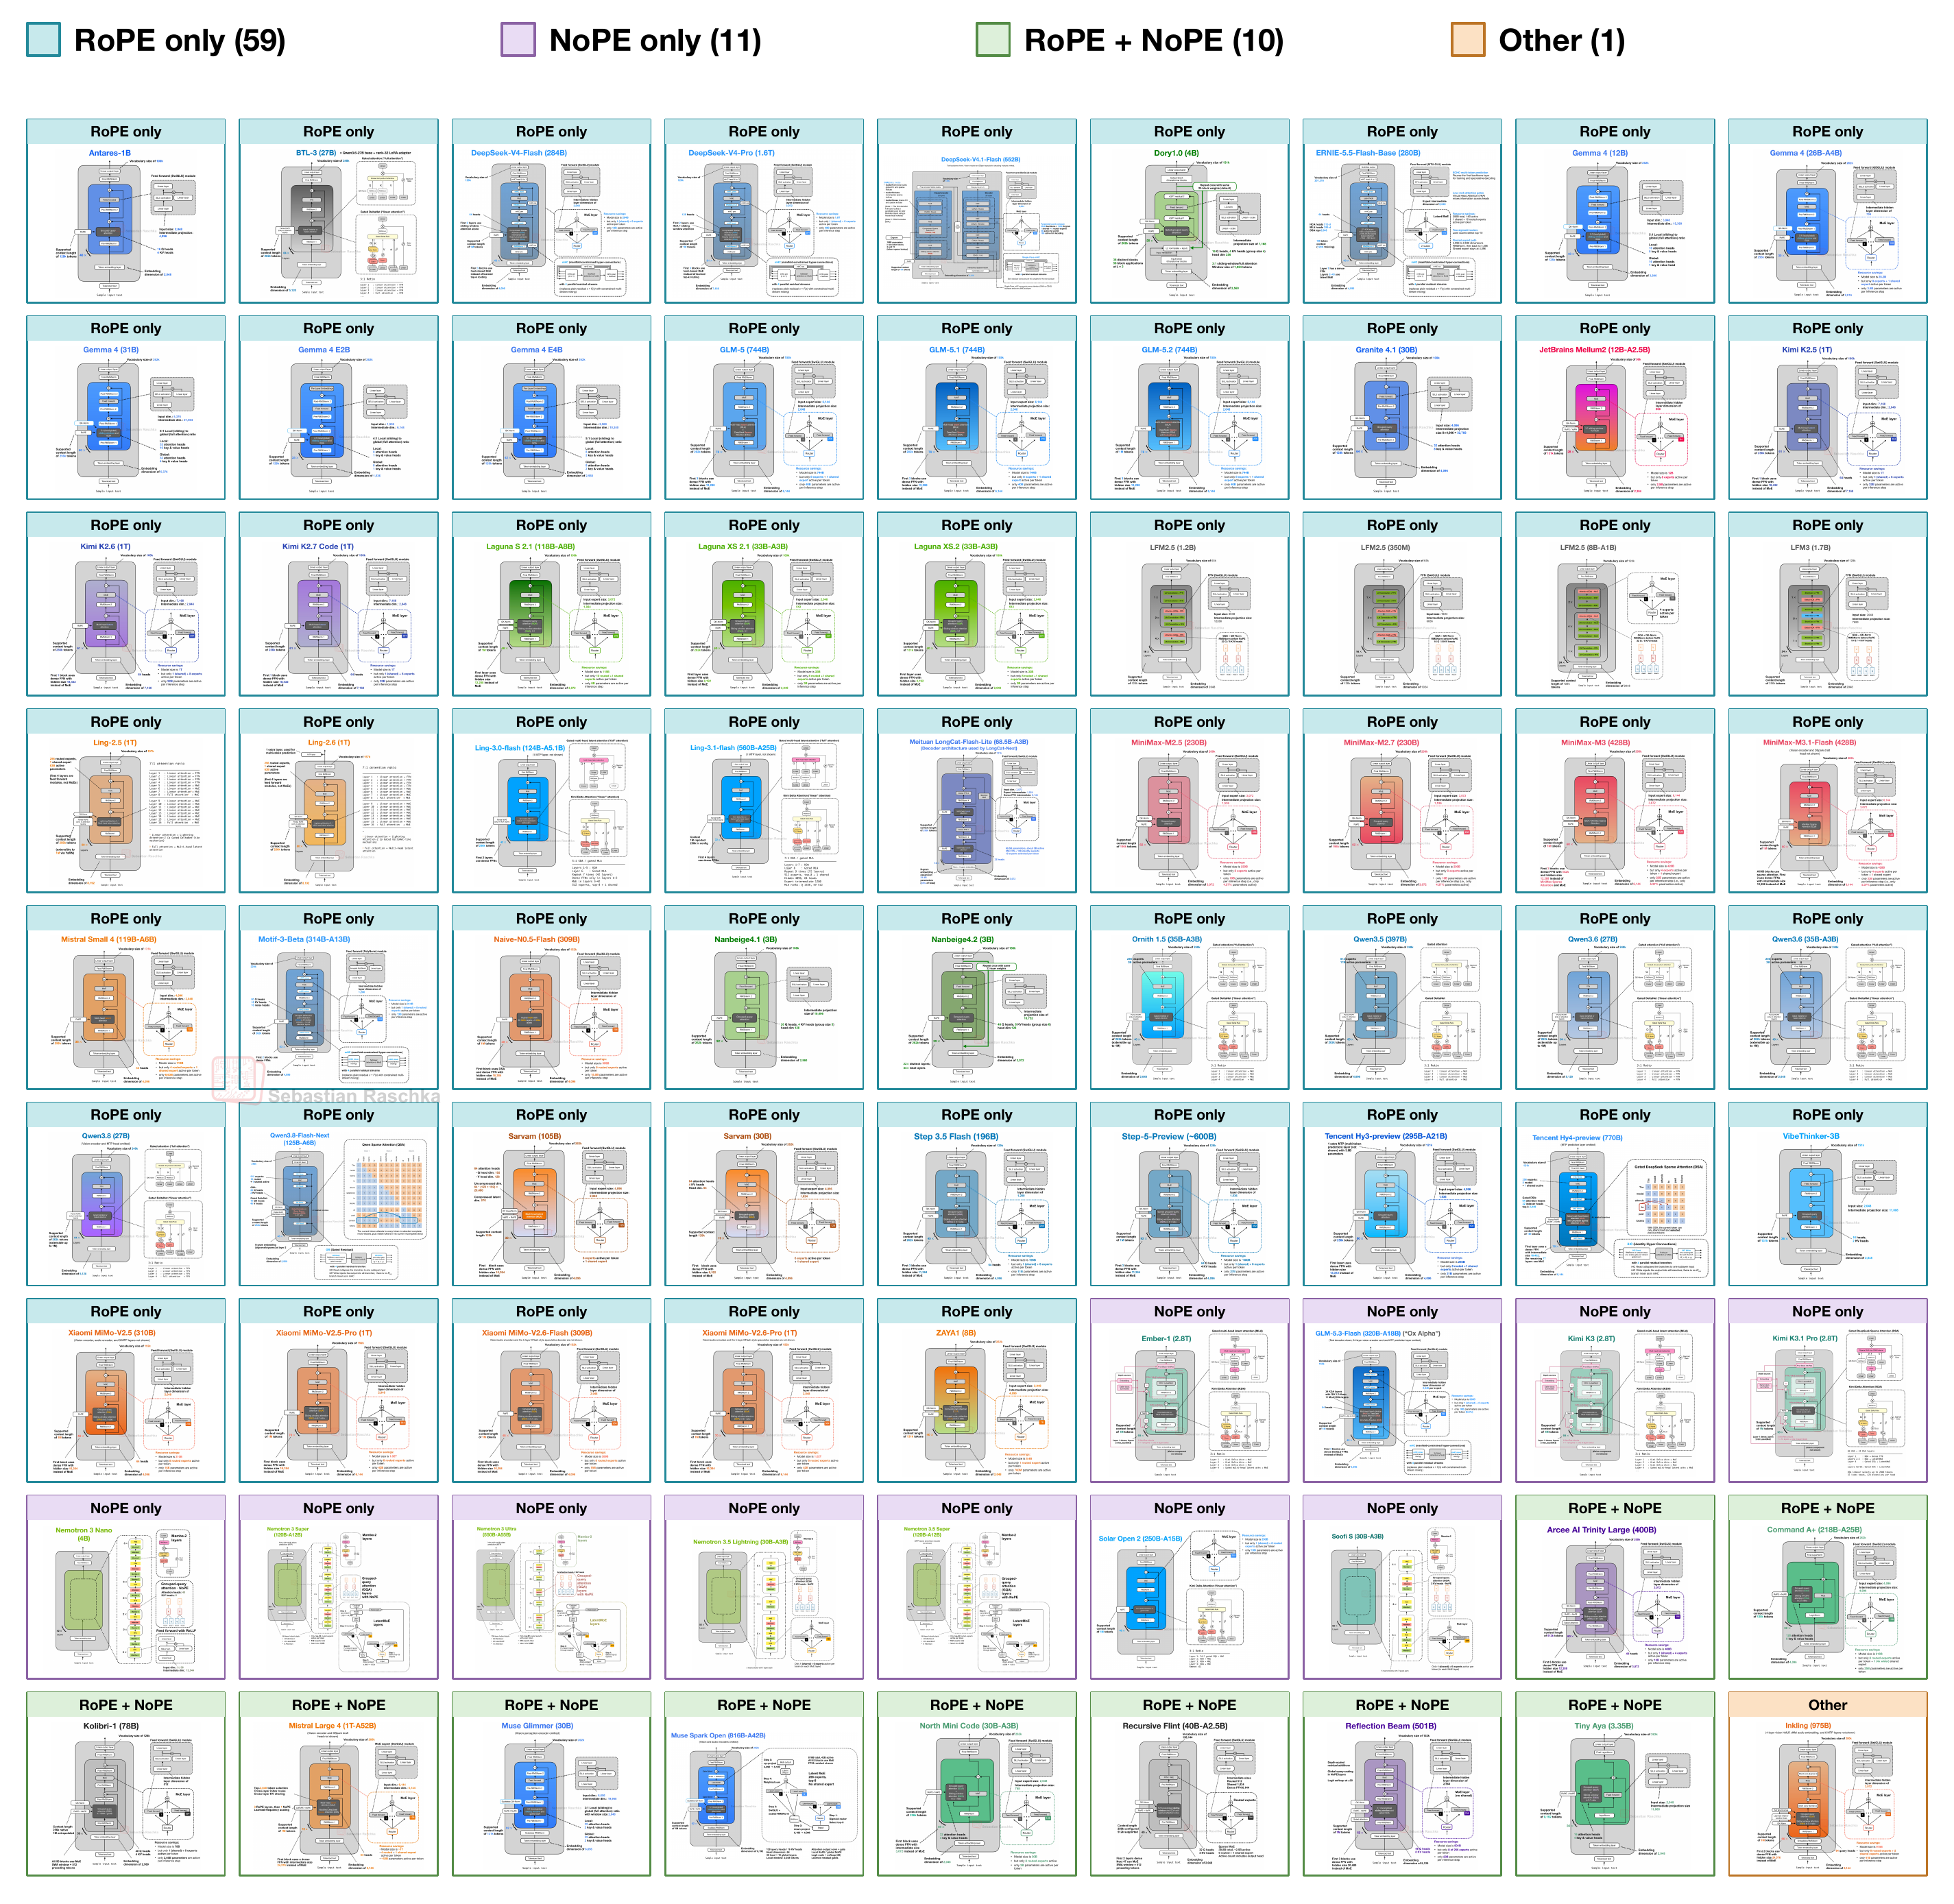
理解现代 LLM 中的位置嵌入:从 GPT-2 到 RoPE 与 2026 年架构
文章系统讲解大语言模型如何编码和处理 token 位置信息,从 GPT-2 的可学习绝对位置嵌入讲到 RoPE 等相对位置方法,配合图示、少量数学推导和一个小型 PyTorch 实现,并盘点 2026 年开源权重模型在位置编码上的选择(包括部分架构省略显式位置编码的做法)。
Ahead of AI · 论文、原理、架构
资料库收录的全部内容,新的在前。
文章系统讲解大语言模型如何编码和处理 token 位置信息,从 GPT-2 的可学习绝对位置嵌入讲到 RoPE 等相对位置方法,配合图示、少量数学推导和一个小型 PyTorch 实现,并盘点 2026 年开源权重模型在位置编码上的选择(包括部分架构省略显式位置编码的做法)。
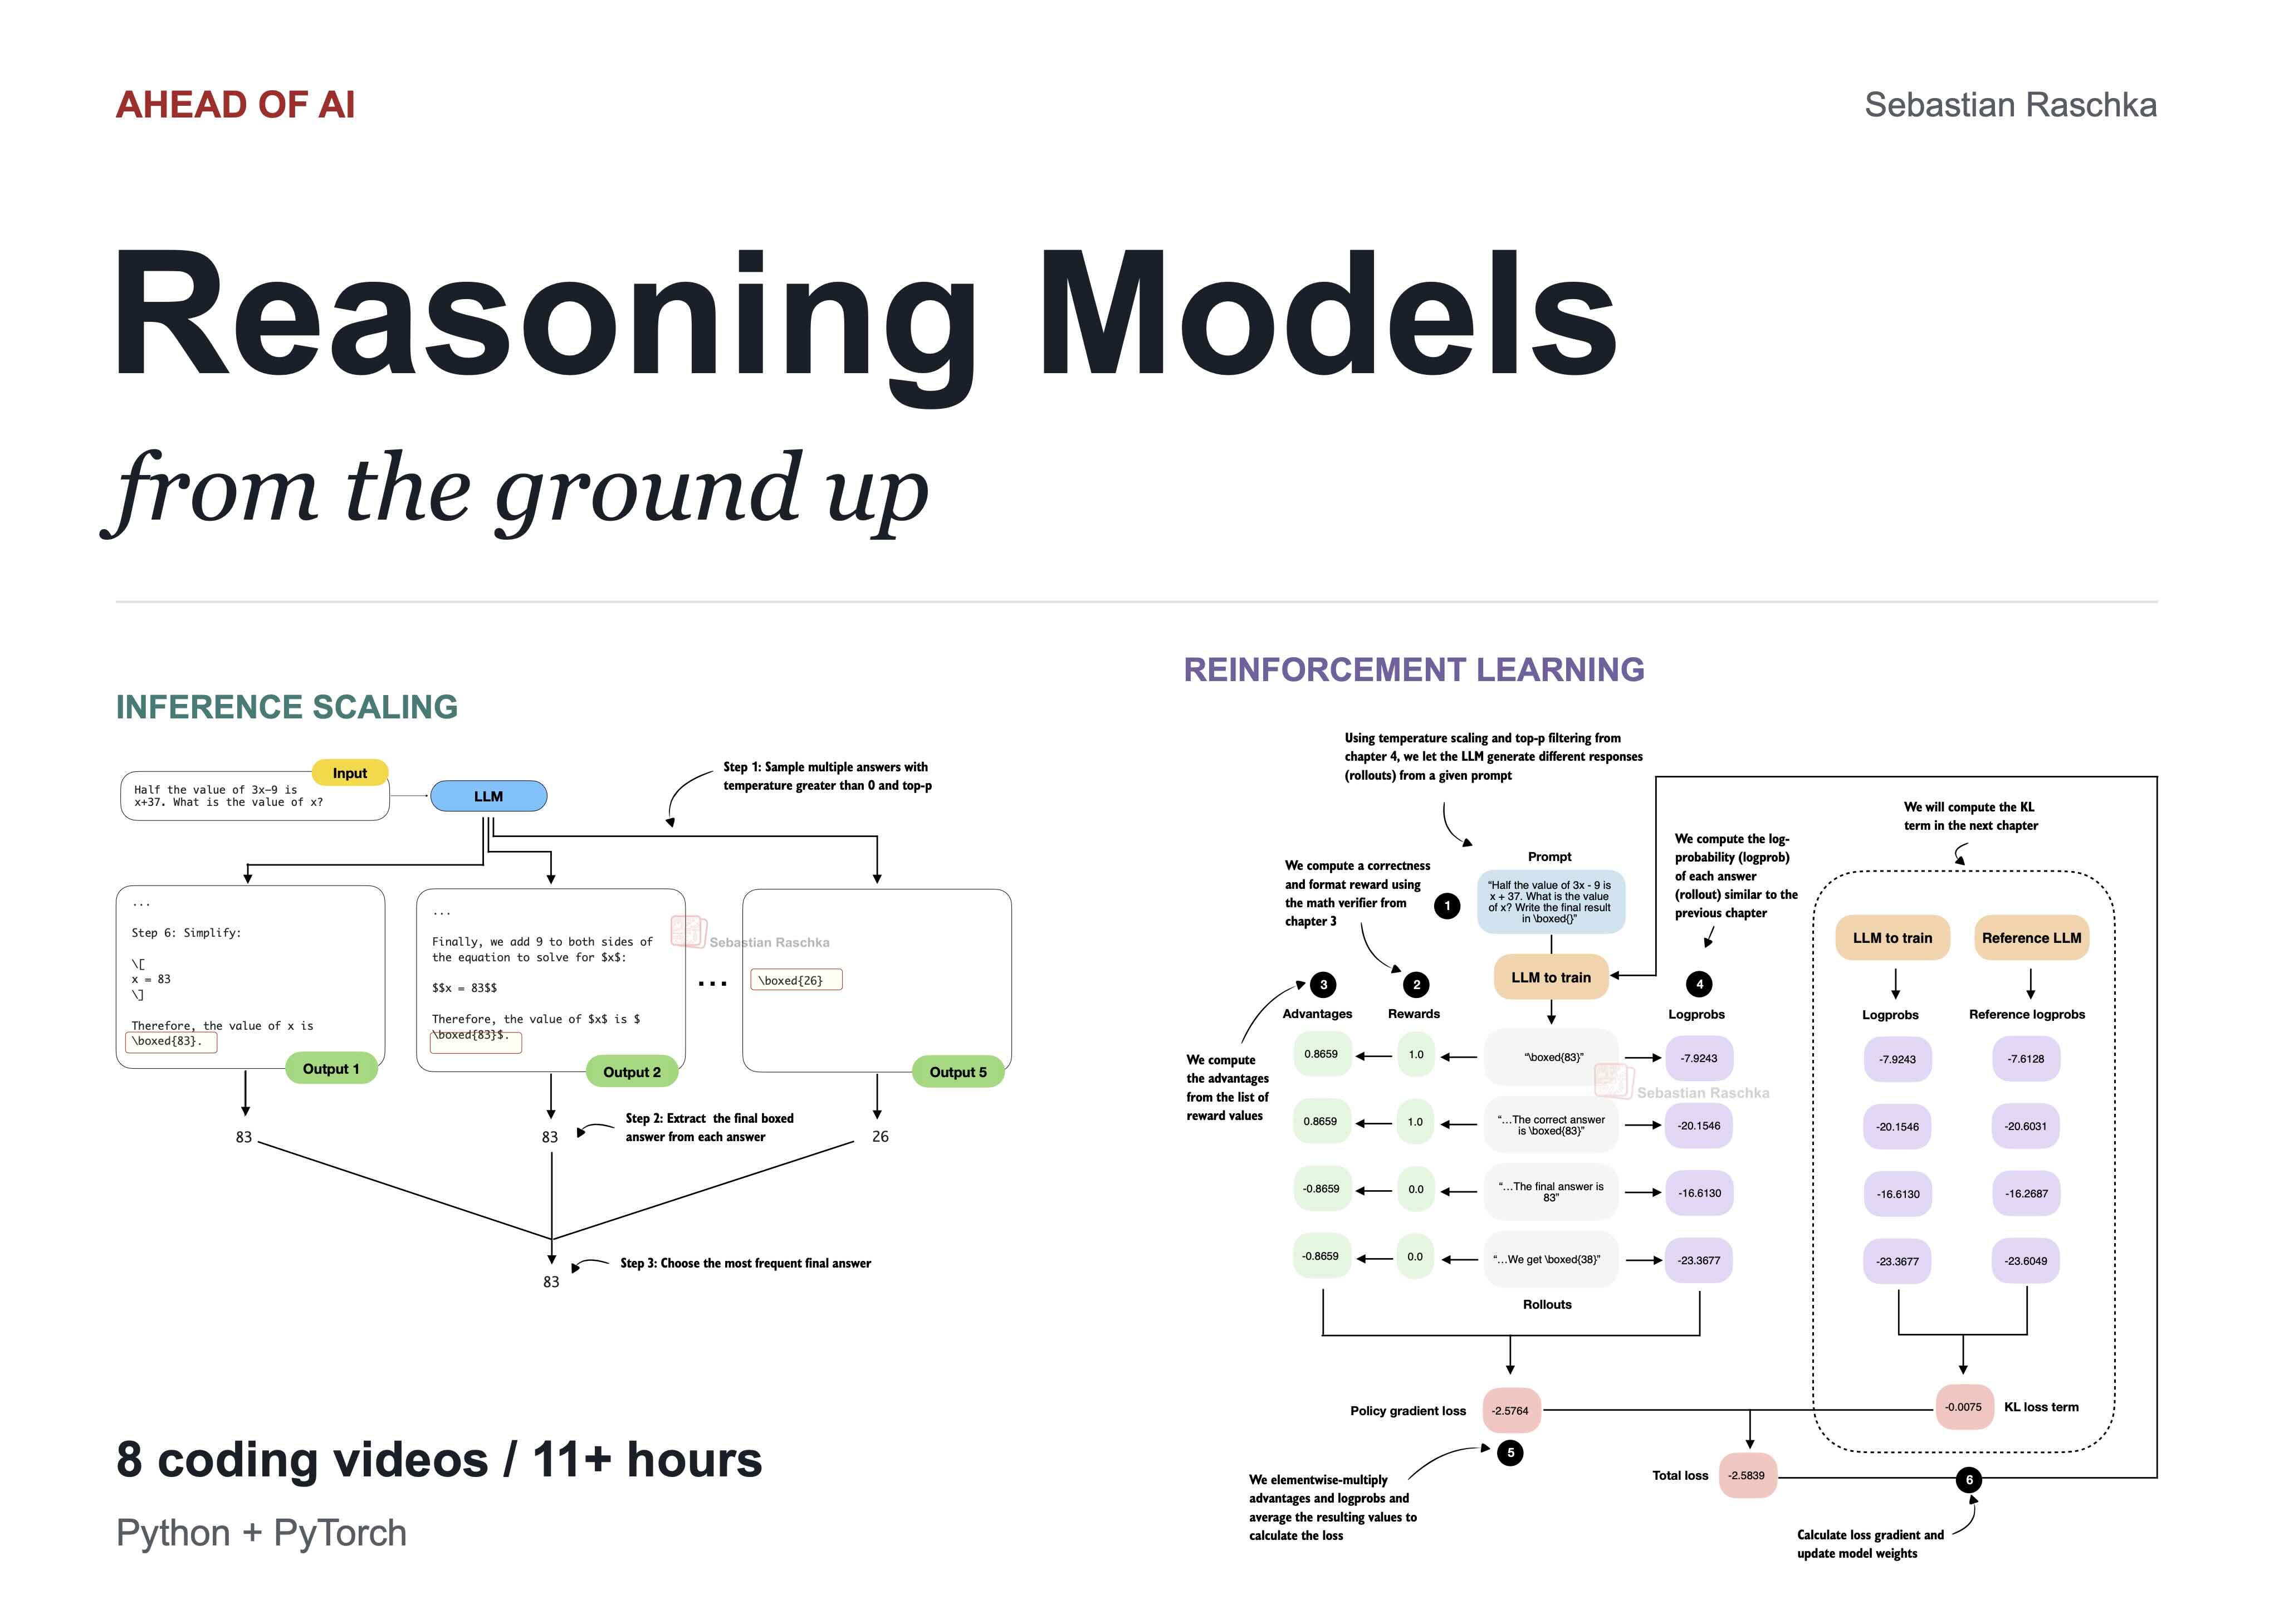
Sebastian Raschka 在 Ahead of AI 发布 8 集、共 11 小时的视频课程,配套其《Build a Reasoning Model (From Scratch)》一书,用 Python 和 PyTorch 从一个预训练的 Qwen3 0.6B 模型出发,亲手实现评测、推理时扩展、强化学习和蒸馏。文章还用一个“引擎与整车”的类比,说明传统 LLM、推理模型和 agent harness 三者的关系:推理模型是引擎,harness 负责上下文管理与工具调用。
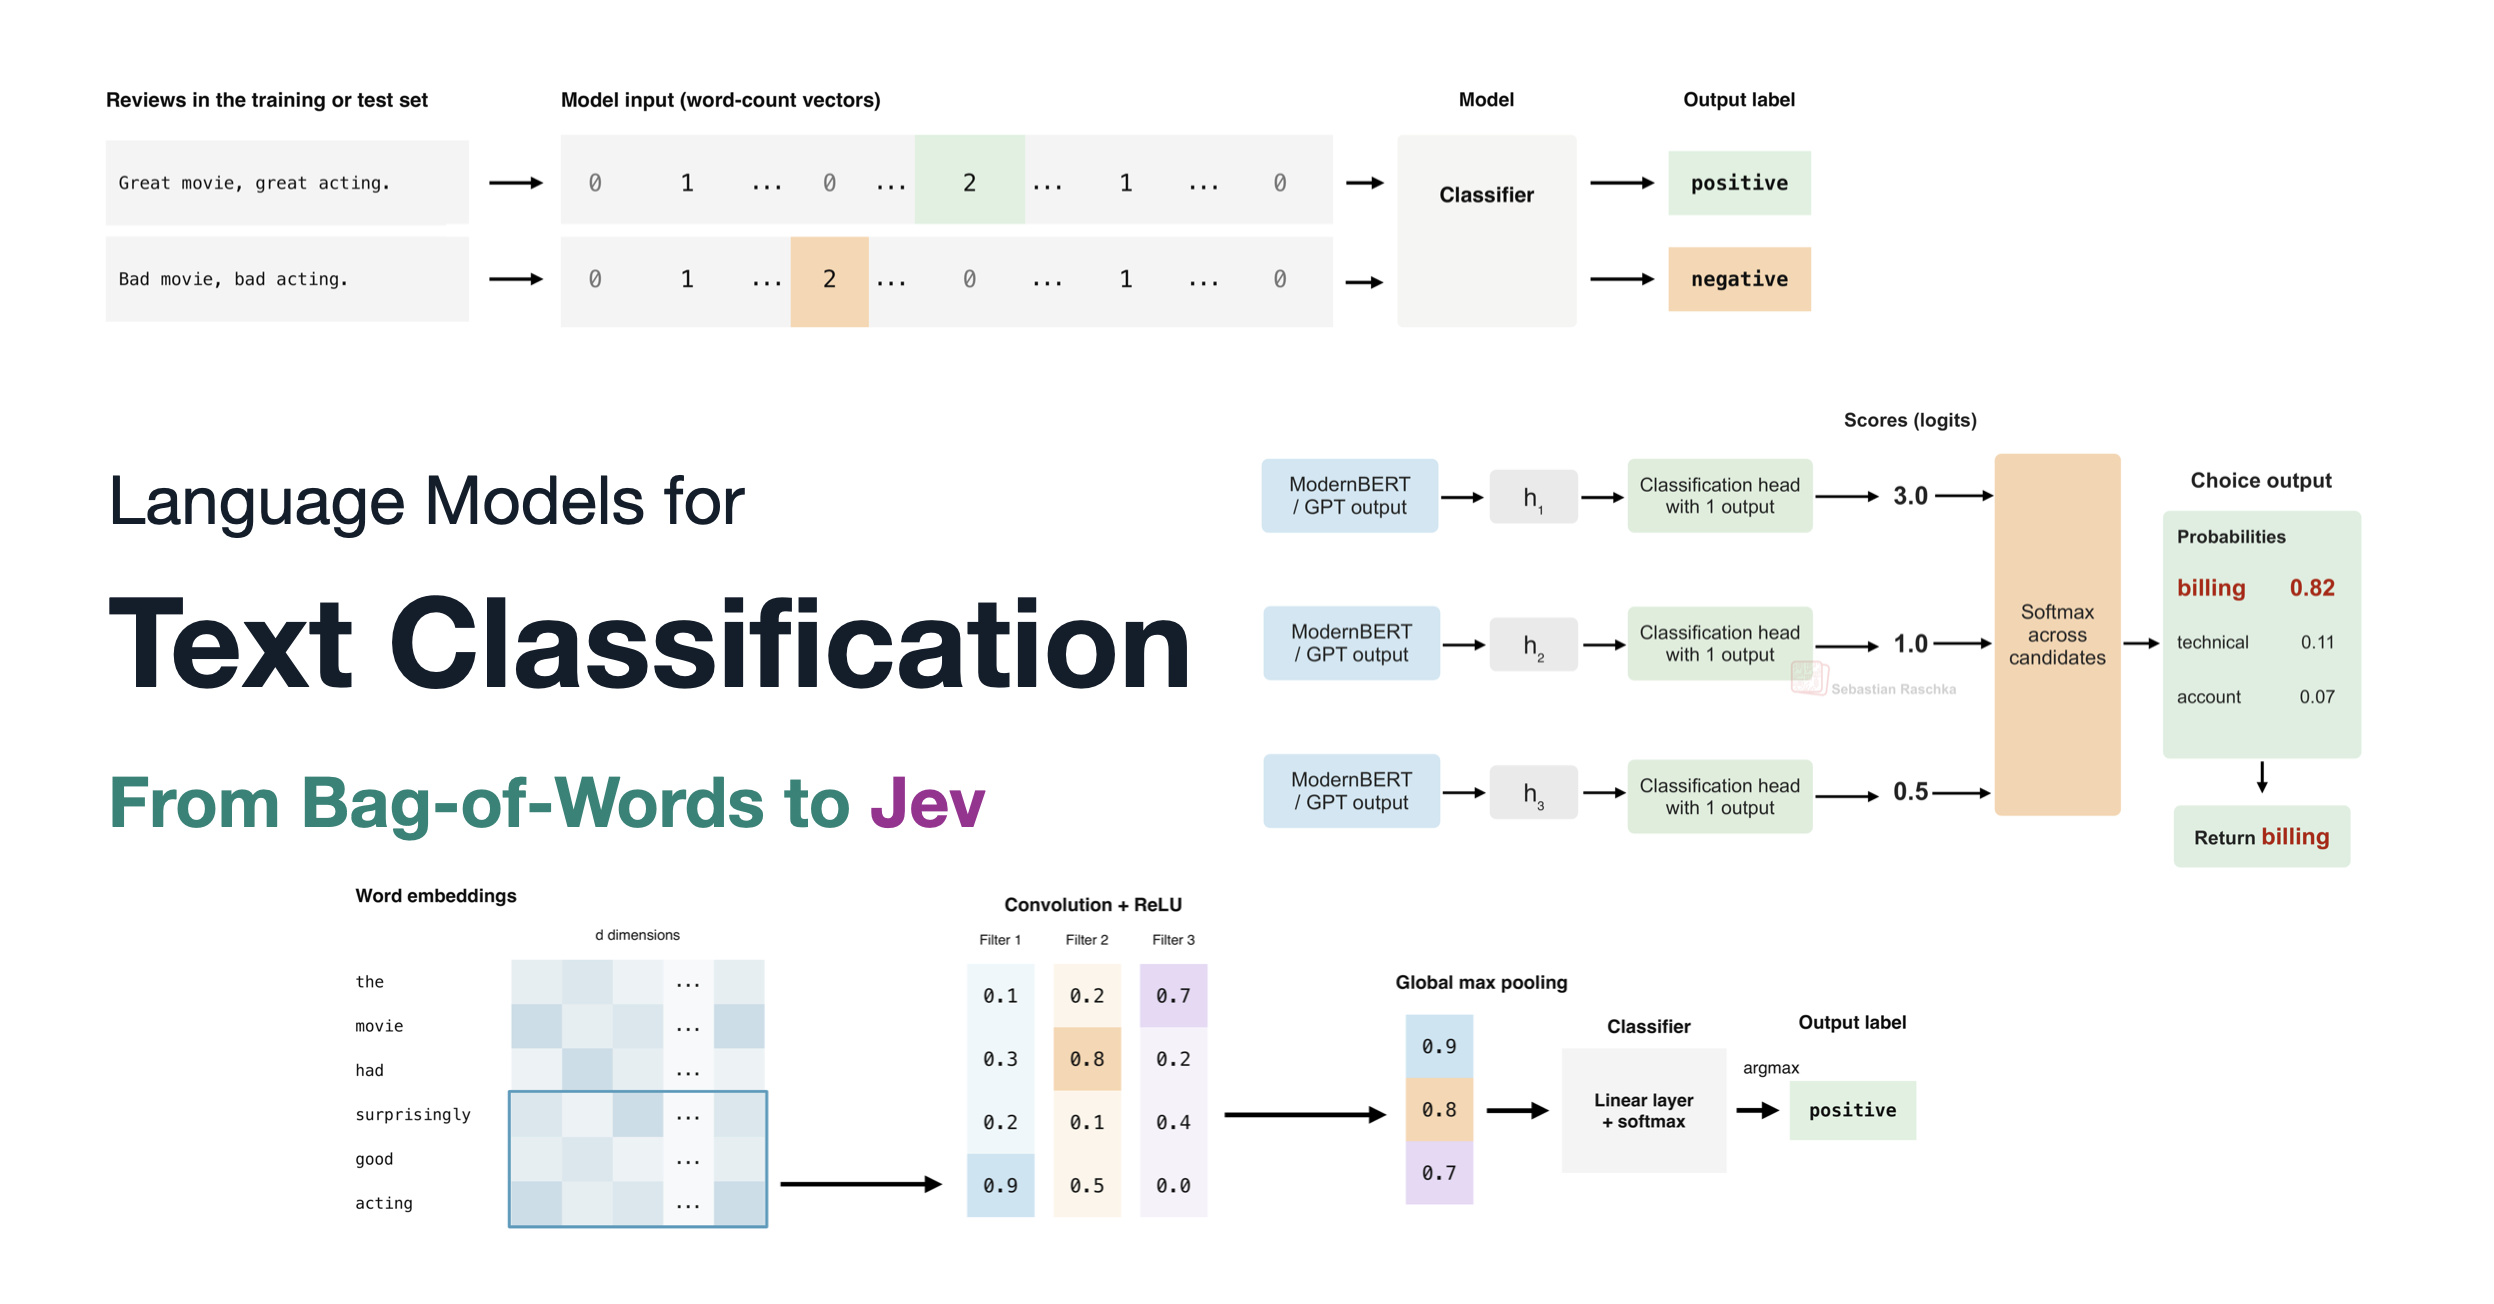
文章从词袋模型、朴素贝叶斯、逻辑回归讲到 CNN、RNN 和 Transformer,梳理文本分类的技术演进,并据此分析近期走红的 Jev 模型:它本质上是文本分类器,但比专用分类器更通用,比通用大模型更快更便宜。作者还给出对 Jev 方法论的推测,帮助读者理解这波热度背后的技术脉络。
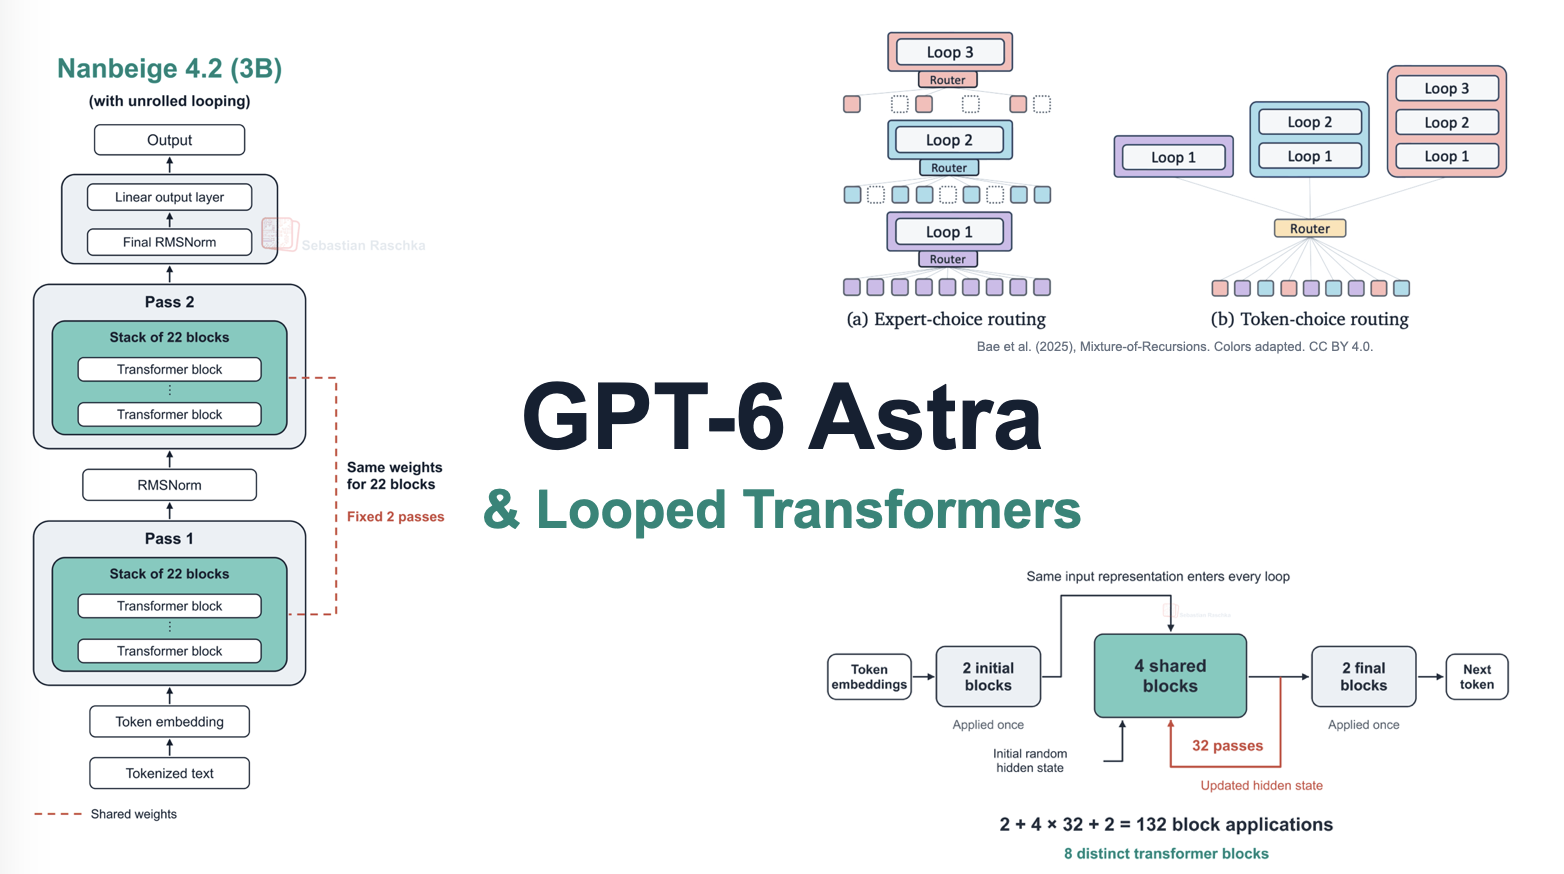
作者先给出对 GPT-6 Astra 的使用印象:它在数学、编码和图形渲染类任务上全面超越前代,计算机使用能力尤其突出,并讨论了用 Mac 集群做 computer-use 强化学习训练的思路。文章随后详细解释「循环 Transformer/循环深度」是什么,辨析它与「隐藏思维链」传闻之间的关系,并补充了近期相关论文的新见解。
Ahead of AI 作者用 52 页幻灯片和 48 分钟视频讲解 Anthropic 为 Claude 输出添加文本水印的机制。内容从 LLM 逐 token 生成和采样过程讲起,说明水印只是嵌入常规生成流程中的一个小改动,并讨论水印可能失效或被去除的原因。
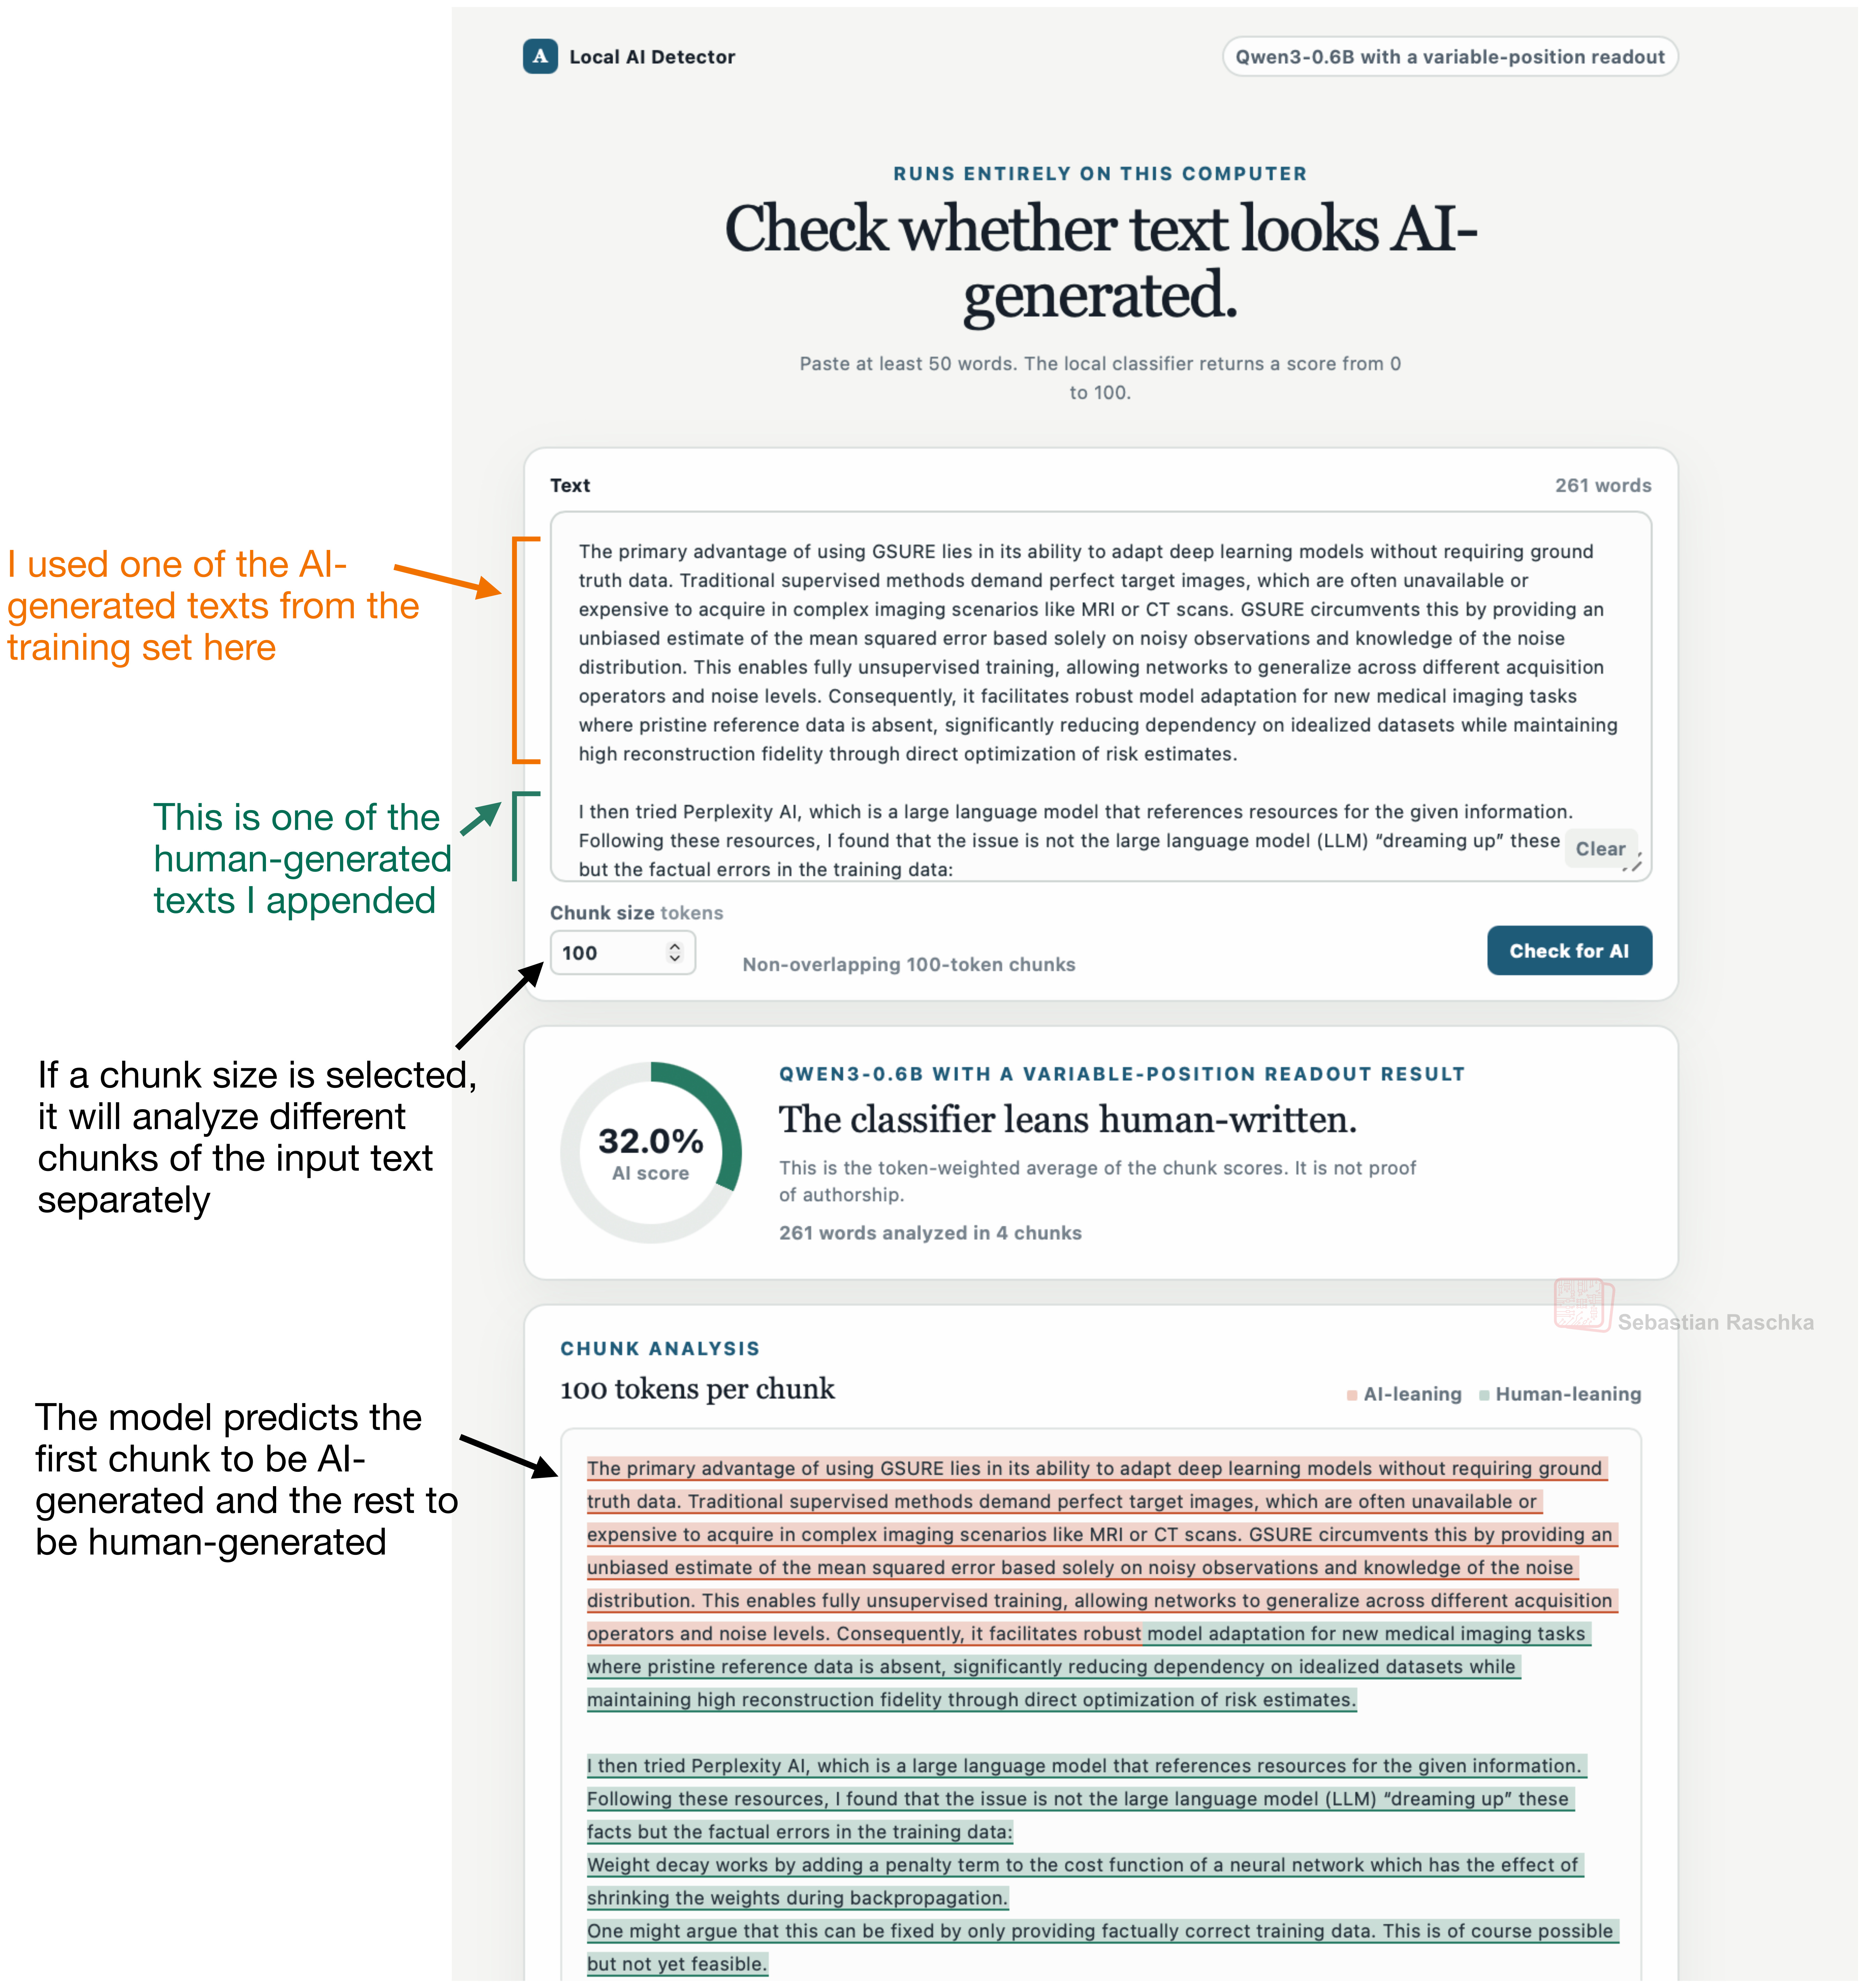
作者以 Substack 的 AI 检测功能为引子,演示如何微调 DistilBERT 分类器构建一个输出 0–100 分的 AI 文本检测器,并把它当作 verifier 来训练小模型规避检测。项目覆盖评测、训练和本地部署,最终产出可被人类和 Agent 调用的检测 API 与浏览器界面。
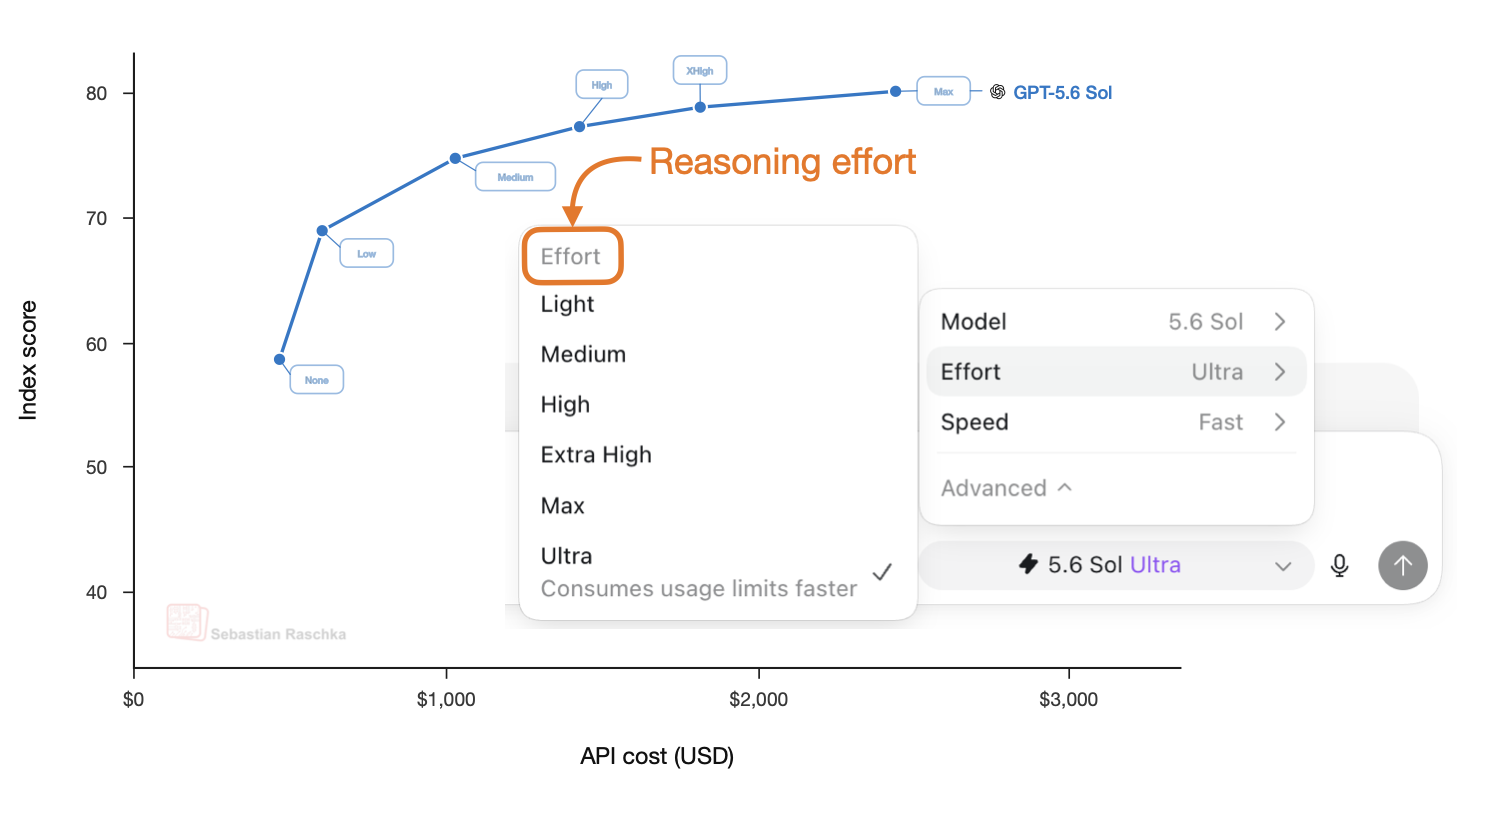
文章从推理模型的定义和 RLVR 训练讲起,说明推理能力如何通过可验证奖励的强化学习获得,以及推理时计算扩展(如自一致性、自我修正)如何提升表现。在此基础上,作者解释如何训练出带有多个推理强度档位的模型,类似 GPT-5.6 系列提供多档 effort 设置的做法。
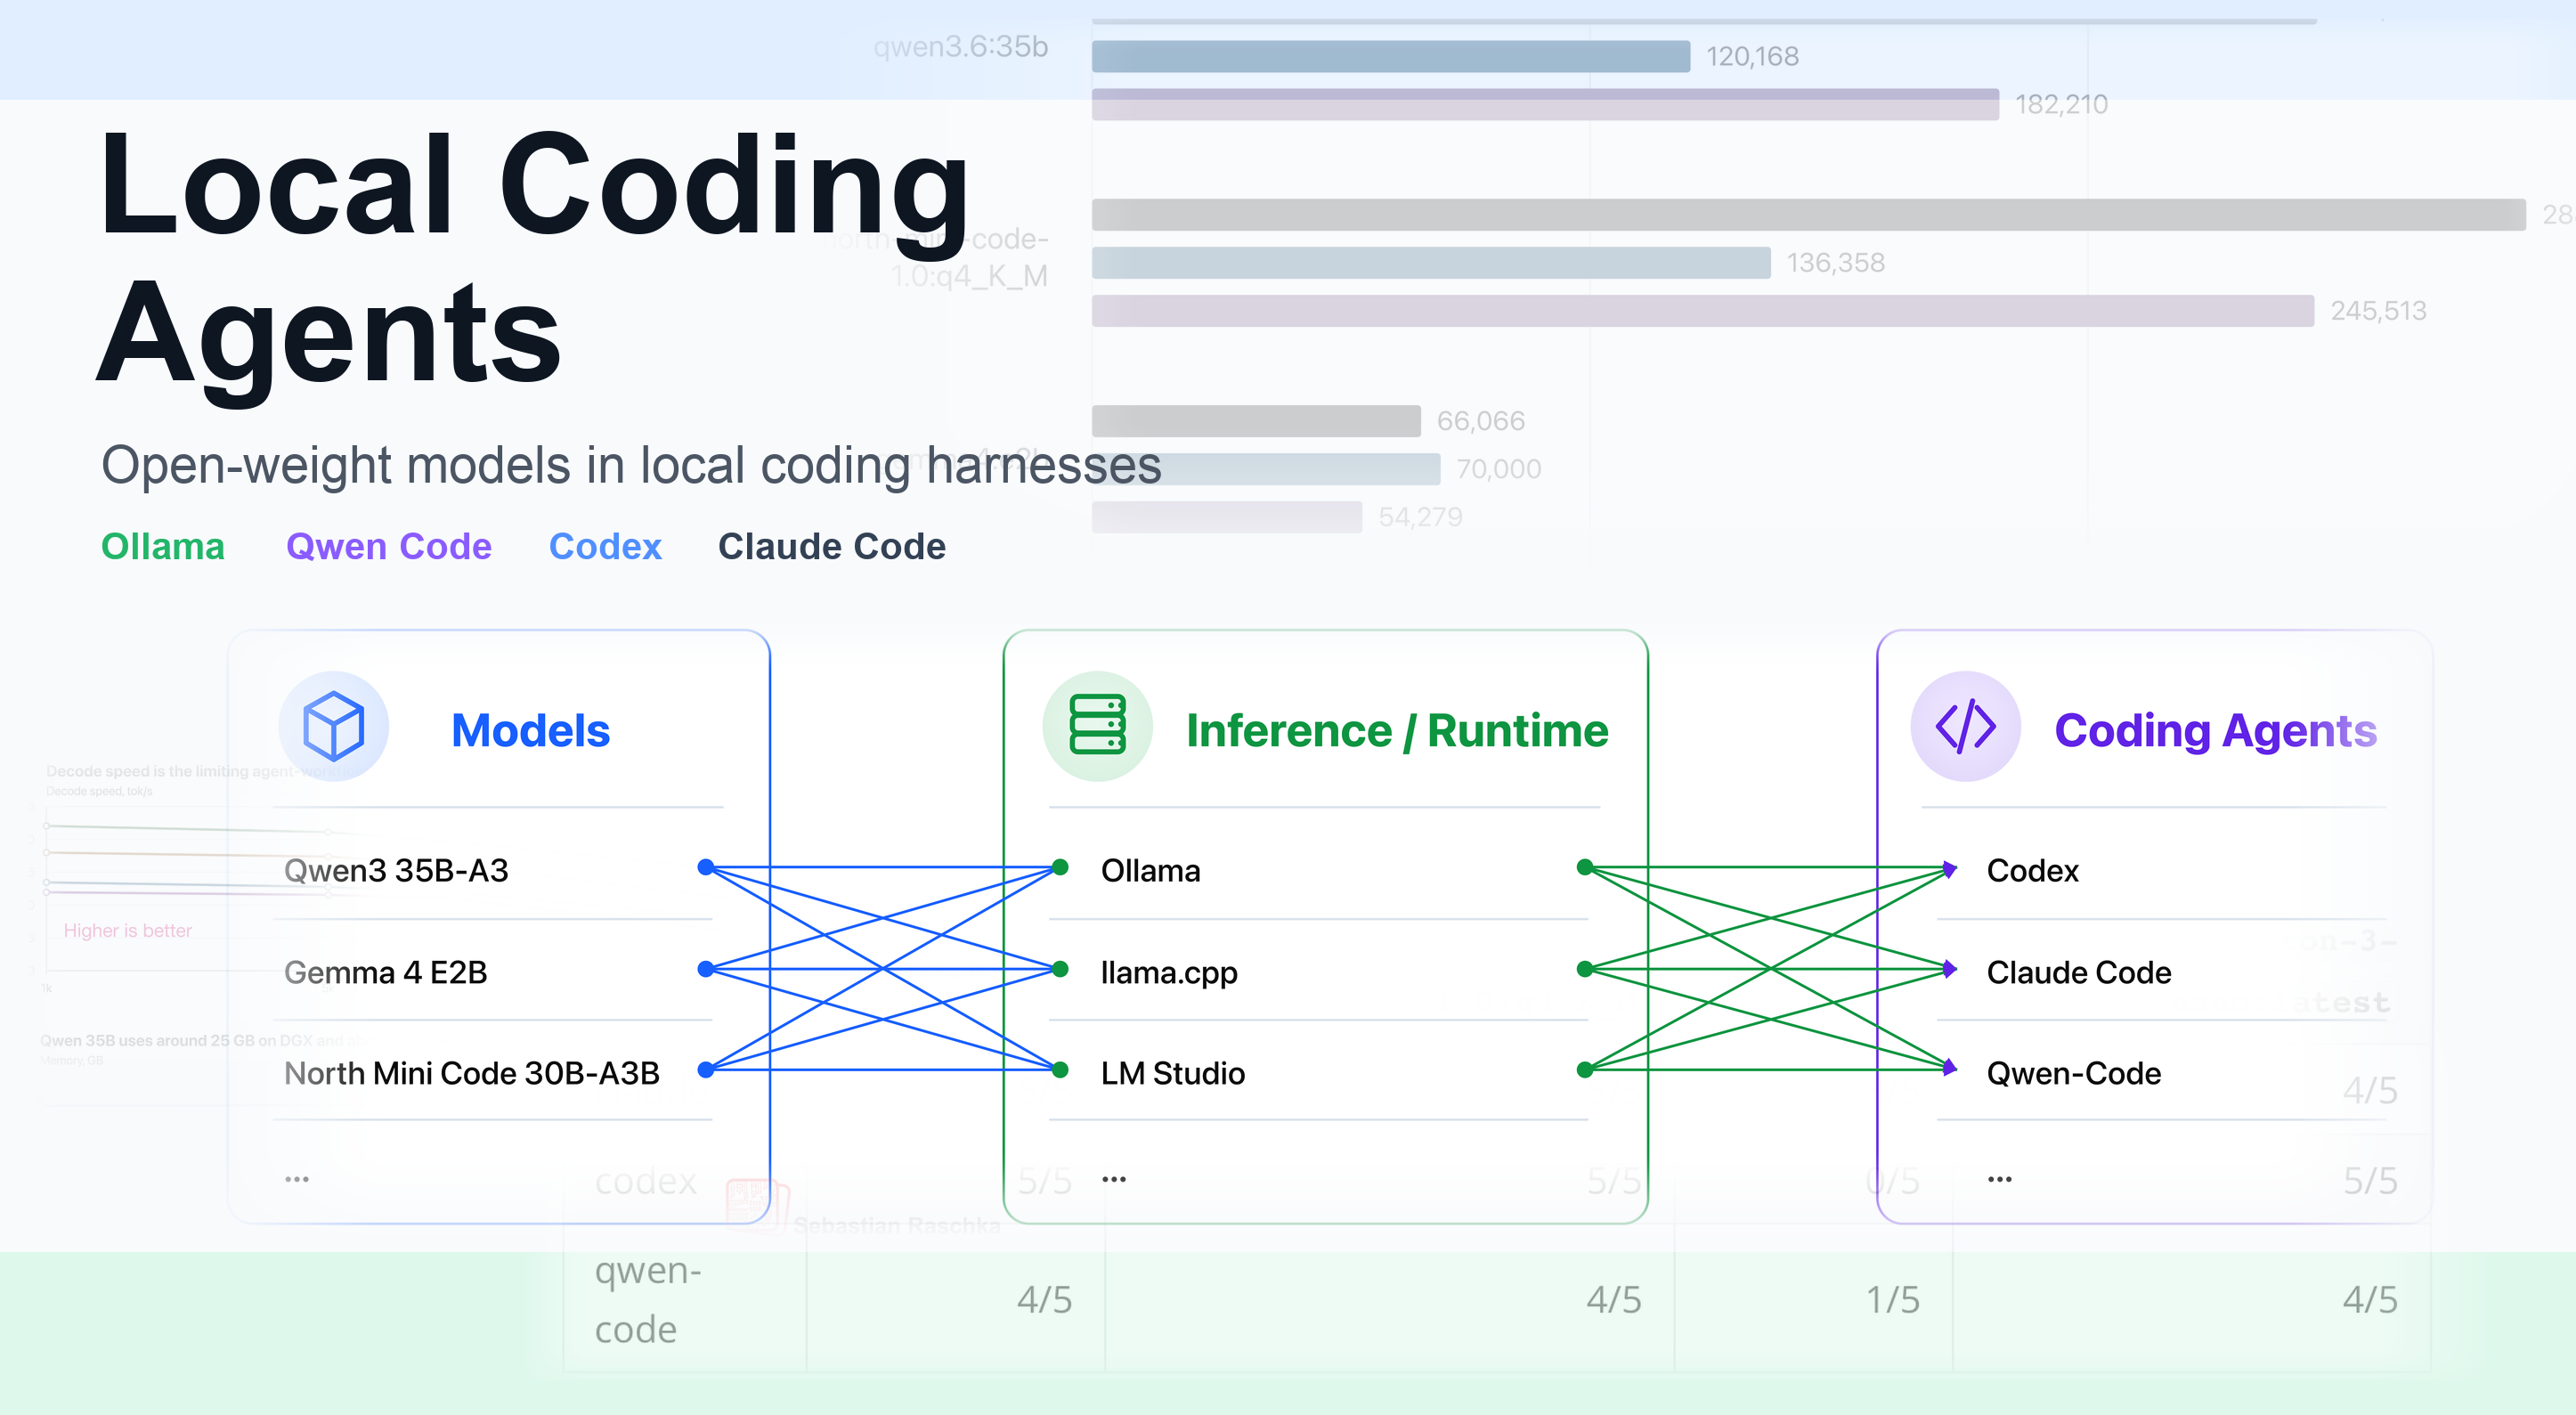
这是一篇教程,讲如何用本地部署的开放权重 LLM 配合开源编码 harness(如 Qwen-Code、Codex、Claude Code)搭建一个能读写文件、执行命令并验证改动的本地编码 Agent。作者以 Qwen3.6 35B-A3B 为例,介绍了本地推理服务的选型,并引用基准说明 Qwen 模型在其自家 harness 中表现更好。
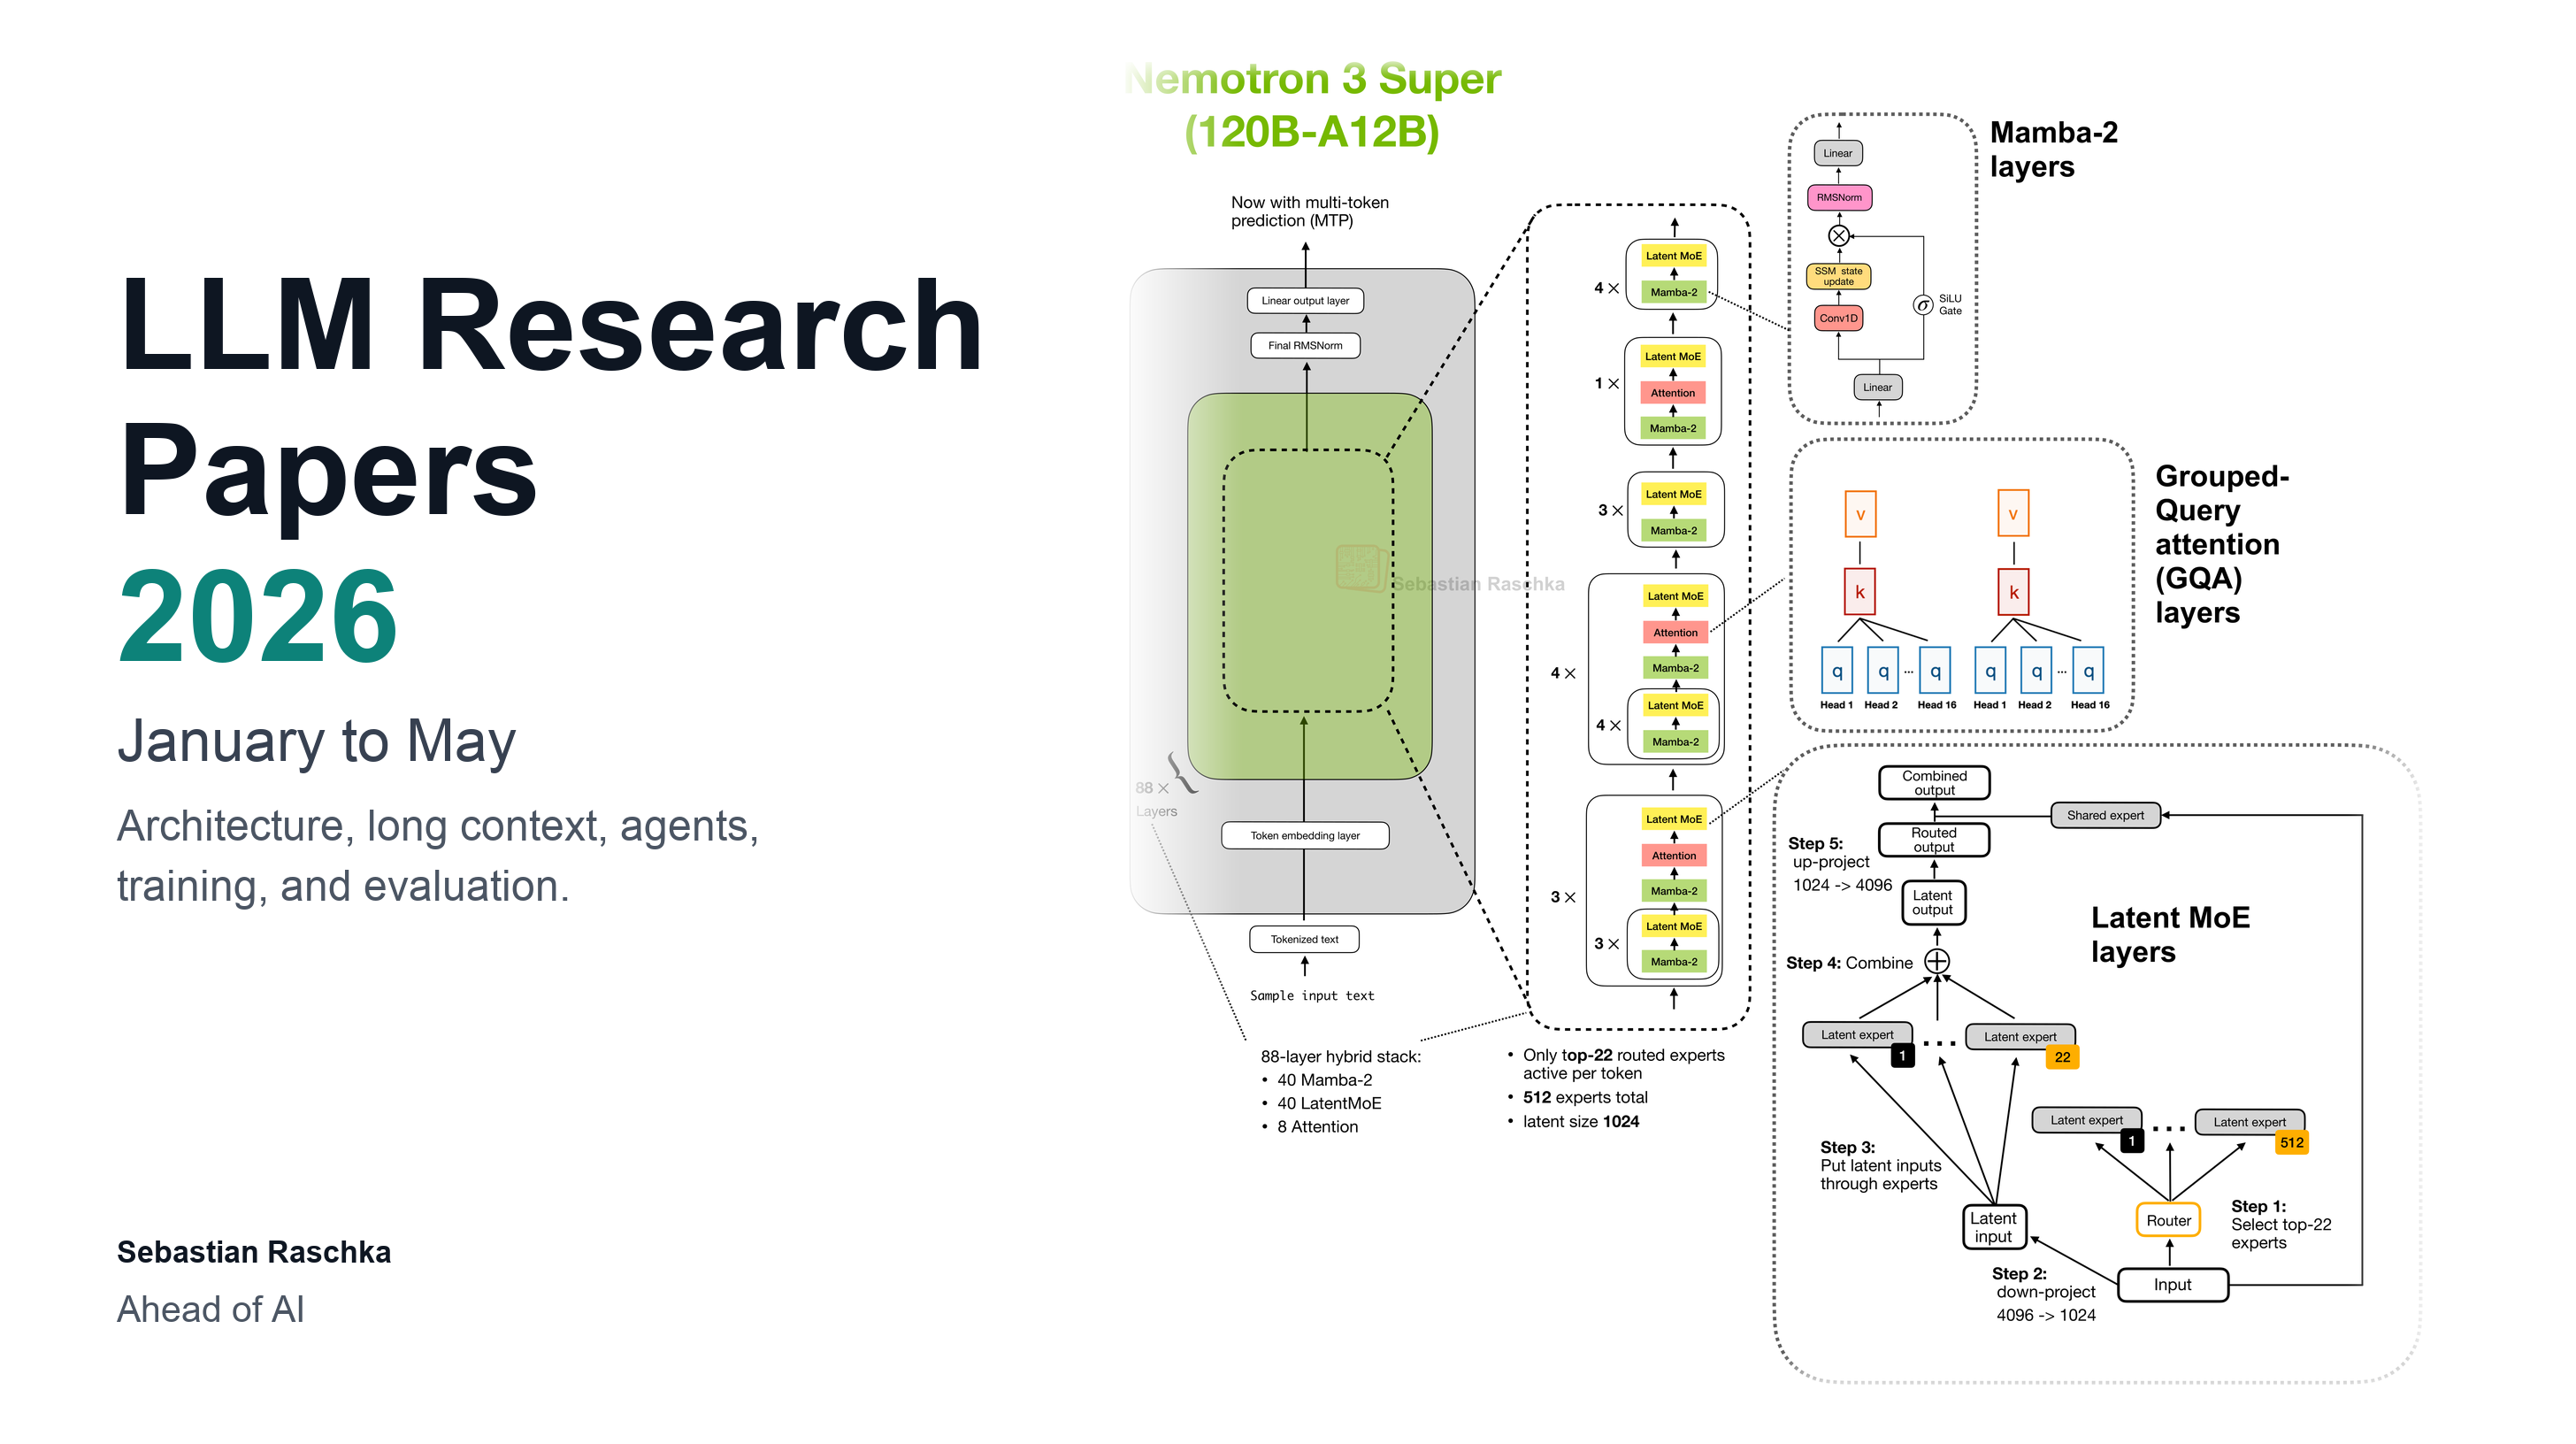
Sebastian Raschka 整理了自己 2026 年 1 至 5 月收藏的 LLM 研究论文,按架构与模型设计、高效训练与扩展、推理效率与 KV Cache、稀疏注意力与长上下文、推理与测试时计算、强化学习与 RLVR、Agent 系统与工具使用、编码 Agent、扩散语言模型、评测基准等类别组织。作者指出今年架构工作不再只是把 Transformer 做大,混合架构(注意力层与 Mamba-2 等状态空间层交替)、MoE 容量分配、激活行为与表征几何成为热点,并推荐 Nemotron 3 Super 技术报告作为必读。